コンピュータビジョンとは何か?
コンピュータビジョンは、画像や映像を入力にして、そこに 何が・どこに・どんな状態で 写っているかを取り出す技術の総称です。人間の視覚がしている「見て分かる」をコンピュータで行う分野と言えます。
以前は、エッジ(輪郭)や色などの特徴を人が設計して取り出す方法が中心でした。2012年に、大規模な画像データセット ImageNet を使った画像認識の競技会で、深層学習(CNN)を使った手法が大きく精度を上げたことをきっかけに、深層学習が主流になりました。深層学習そのものは ディープラーニングとは で解説しています。
画像の入口であるカメラの仕組み(光を電気信号に変えるイメージセンサ)は、CMOSイメージセンサとは で整理しています。CV は、センサが作った画像を「意味」に変える側の技術です。
代表的なタスクは、何が違う?
タスクの違いは、「出力が何か」で比べると区別しやすくなります(当サイトの整理)。
画像分類
- 出力画像全体に1つのラベル
- 位置の示し方示さない(画像全体で1つの答え)
物体検出
- 出力物ごとのラベル
- 位置の示し方枠(四角)で示す
セグメンテーション
- 出力画素ごとのラベル
- 位置の示し方画素単位で形まで分ける
1枚に複数の物が写る場面では検出、形まで要るならセグメンテーション。
| タスク | 出力 | IoTでの使いどころの例 |
|---|---|---|
| 画像分類 | 画像全体に1つのラベル(例:良品/不良品) | 製品の外観検査で、合否を判定する |
| 物体検出 | 物ごとの位置(枠)とラベル | 通路の人や車の数を数える、侵入を見つける |
| セグメンテーション | 画素ごとのラベル(領域の形) | 農地の画像で作物と雑草の領域を分ける |
| 姿勢推定 | 人の関節などの位置 | 作業者の姿勢から負担や転倒を見つける |
| 物体追跡 | 動画の中で同じ物の位置の変化 | 人流や車の動線を把握する |
| 文字認識(OCR) | 画像の中の文字 | アナログメーターの値を読み取る、ナンバーを読む |
試験では「位置まで分かるのはどれか」「画素単位で分けるのはどれか」のように、出力の違い で問われると考えておくと対応しやすくなります(推定)。
分類:画像全体
画像に車が含まれるかなど、画像全体の種類を答える。
検出:対象の位置
それぞれの車がどこにあるかを、囲む枠などで示す。
領域分割:画素の領域
車に当たる領域を、画素ごとに区別する。
対象の種類だけか、位置まで必要か、領域まで必要かで、タスクを分ける。
当サイトが描いた説明用の絵です。実際の画像認識モデルの出力や精度比較ではありません。領域分割では、個体ごとの区別の有無も手法によって異なります。
カメラから結果が出るまで、どう流れる?
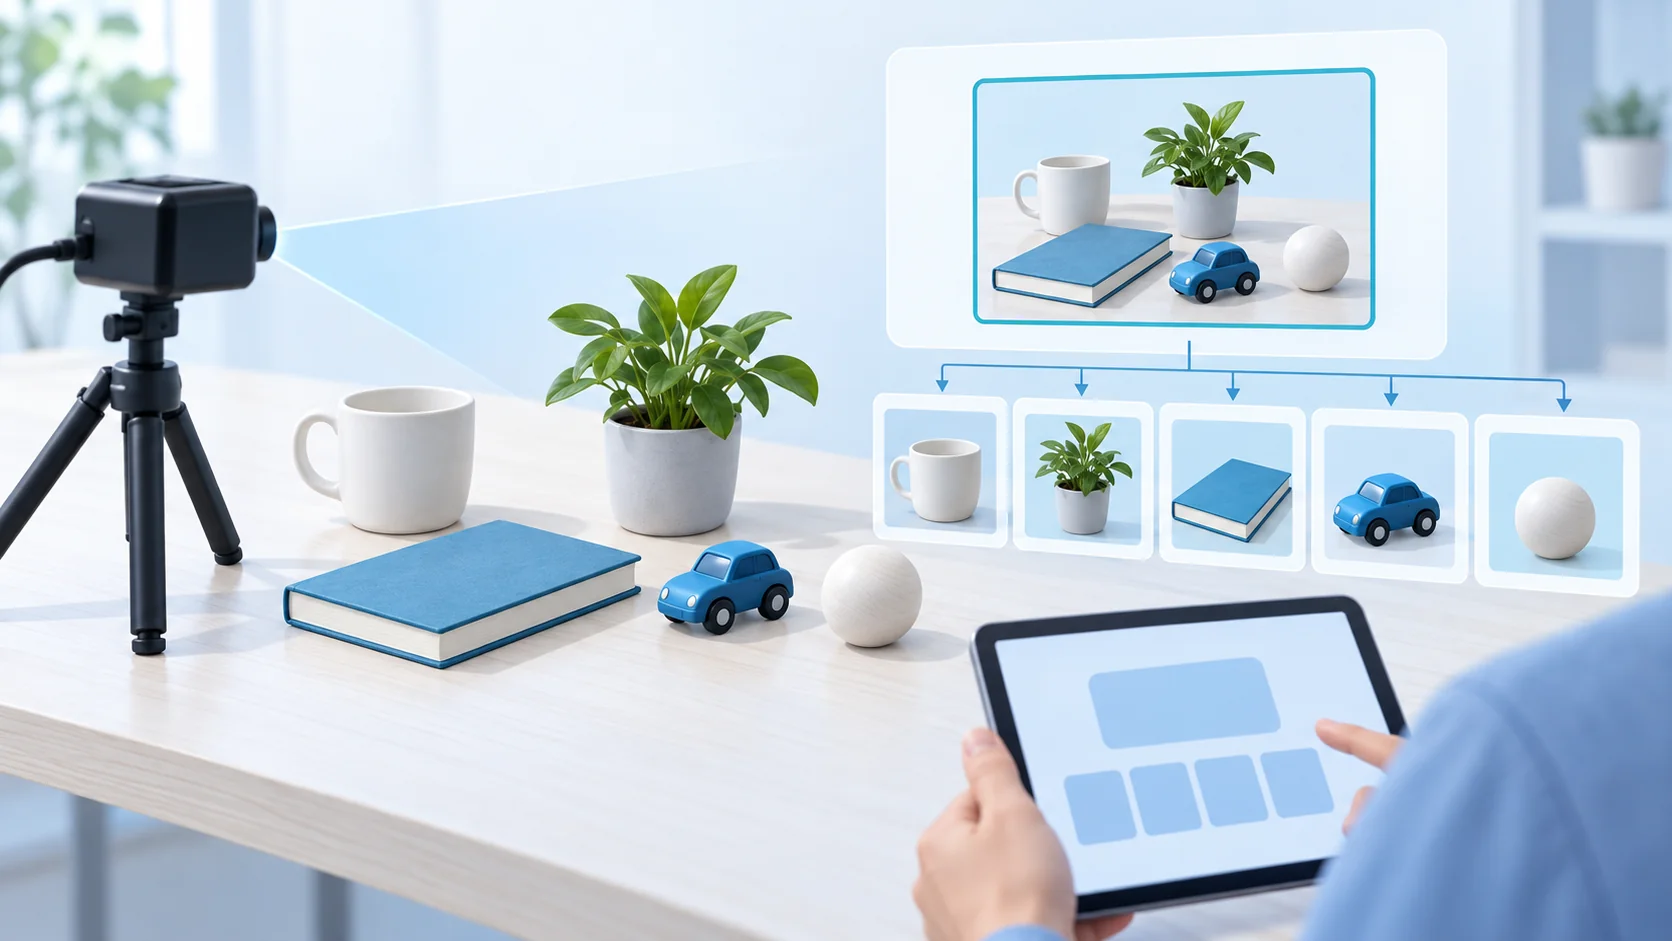
- 1
撮影
イメージセンサが光を画像データに変える
- 2
前処理
大きさをそろえる、明るさやゆがみを補正する、ノイズを減らす
- 3
推論
学習済みのモデルで分類・検出などの結果を得る
- 4
後処理と判断
集計やしきい値との比較で「異常あり」などにする
- 5
送信と活用
結果をクラウドに送り、通知・記録・分析に使う
推論をカメラやゲートウェイの近くで行い、結果だけを送るのがエッジAI。通信量と遅延を減らせる。
- 撮影: カメラ(イメージセンサ)が光を画像データに変えます。
- 前処理: 大きさをそろえる、明るさやゆがみを補正する、ノイズを減らすなどの処理をします。
- 推論: 学習済みのモデルに画像を入れ、分類・検出などの結果を得ます。
- 後処理と判断: 結果を集計したり、しきい値と比べたりして、「異常あり」などの判断にします。
- 送信と活用: 判断や集計の結果をクラウドに送り、通知・記録・分析に使います。
推論をどこで行うかが IoT の設計の要点です。映像をそのままクラウドへ送ると通信量が大きく、遅延も生じます。そのため、カメラやゲートウェイの近くで推論し、結果だけを送るエッジAI の構成がよく選ばれます。詳しくは エッジAIとは を参照してください。
使うときに何に注意する?
- プライバシー: 人が写る映像は個人情報に当たる場合があります。撮影していることの掲示、必要な範囲だけの撮影、映像を残さず結果だけを保存する設計などを検討します。
- 環境の変化: 明るさ、天候、カメラの汚れや向きのずれで精度が落ちます。現場での検証と定期的な見直しが必要です。
- 学習データの偏り: 学習に使った画像と違う条件(別の製品、別の季節)では、精度が下がることがあります。
- 誤検知と見逃し: どちらを減らすかで、しきい値の決め方が変わります。検査では見逃しの害が大きいことが多いです。
CV の開発では、画像処理のオープンソースのライブラリ OpenCV などがよく使われます。用語の理解を問題で確かめるなら IoT基礎の無料お試し も使えます。
どこで取り違えやすい?
- 画像分類と物体検出: 分類は画像全体に1つの答え、検出は物ごとの位置と種類です。1枚に複数の物が写る場面では検出が必要になります。
- 物体検出とセグメンテーション: 検出は枠(四角)で位置を示し、セグメンテーションは画素単位で形まで分けます。
- イメージセンサと CV: イメージセンサは光を信号に変える部品、CV は画像から意味を取り出す技術です。
- エッジで処理すれば個人情報の問題は無い: 送る量や漏れる機会は減りますが、撮影そのものの扱いは別に考える必要があります。
確認問題1
タスクの区別
(当サイトの独自問題)1枚の画像に写っている複数の人や車について、それぞれの位置を枠で示し、種類を判定するコンピュータビジョンのタスクとして、最も適切なものはどれか。
選択肢を準備しています。「正解と解説を見る」は先に開けます。
正解と解説を見る
正解:4。物体検出は、物ごとの位置(枠)と種類を出力します。
1:画像分類は画像全体に1つのラベルを付け、位置は出しません。2:次元削減はデータの特徴の数を減らす処理で、CV のタスク名ではありません。3:文字認識は画像の中の文字を読み取るタスクです。
確認問題2
画素単位の処理
(当サイトの独自問題)ドローンで撮った農地の画像を、画素ごとに「作物」「雑草」「土」に分けたい。このとき用いるタスクとして、最も適切なものはどれか。
選択肢を準備しています。「正解と解説を見る」は先に開けます。
正解と解説を見る
正解:1。セグメンテーションは画素ごとにラベルを付け、領域の形まで分けます。
2:姿勢推定は人などの関節の位置を推定するタスクです。3:画像分類は画像全体に1つのラベルを付けるだけです。4:物体追跡は動画の中で同じ物の動きを追うタスクです。
確認問題3
エッジで推論する理由
(当サイトの独自問題)監視カメラの映像をカメラの近くで推論し、検出結果だけをクラウドへ送る構成の主な利点として、最も適切なものはどれか。
選択肢を準備しています。「正解と解説を見る」は先に開けます。
正解と解説を見る
正解:1。映像全体ではなく結果だけを送るので通信量が減り、現場で判断できるので遅延も小さくしやすくなります。
2:推論の場所とカメラの解像度は関係ありません。3:推論に使うモデルは、どこで動かすかに関係なく学習が必要です。4:エッジ側の機器の記憶容量は限られており、無制限ではありません。